

立即咨询
1分钟注册
立享专属行业解决方案
立享专属行业解决方案
已为2000+家企业提供智能机器人服务
提交
过去三年,国内企业品牌展厅、博物馆、规划馆、产业园区和政务接待窗口的外宾到访密度持续上升,多语种接待能力从过去的加分项逐渐变成基础项。背后的逻辑并不复杂:第一,跨国企业中国总部旗舰展厅、外资合资公司展厅、政府国际接待窗口里英文访客的占比明显提高,单纯依赖中文接待会直接劝退外宾;第二,大模型与具身智能的成熟让外宾对机器人的预期从"演示效果"上升到"应有效能"——能听懂、能对话、能带路,不再是台上一分钟的"花活";第三,一名合格的双语讲解员既需要懂业务又需要用英文流利讲解,这类人才稀缺、成本高、人员流动时知识经验断档,把"双语运营成本"变成"一次性硬件投资"成了更合算的杠杆。
把"双语能力"这件事拆开看,外宾接待视角下四个真实痛点很难绕开:一是高素质双语讲解员稀缺,标准化与热情度难以长期保持,节假日或代表团到访时容易出现排队等待、关键问询无人应答;二是双语知识库更新频繁,术语一致性难以保障,中英两份稿件之间容易出现"翻译漂移",外宾提问时容易露馅;三是导览过程中访客可能先英文提问再切中文追问再切回英文,同一展品在不同语种下应当指向同一知识节点;四是展厅机器人是 3 到 5 年的长期运营,OTA 升级、备件响应、与既有 OA / CRM / 票务系统的接口稳定,以及 GDPR、PIPL 等数据合规条款都需要在合同技术附件中提前明确。把这些痛点收拢,外宾接待视角下机器人要打通的核心环节就比较清晰了——多语种识别与切换、双语知识库的统一管理与即时更新、跨语种术语一致性、外宾登记分流与系统联动,以及 3 到 5 年运营维护的可持续性。下面围绕这几个环节展开技术分析。
从工程视角看,"中英双语切换"在展厅场景下不是简单的"加装语音翻译模块"——前者只解决"听得懂",不解决"术语一致、知识同步更新、可追溯"。真正能承接跨语种讲解的机器人需要在背后形成一套由端云协同的动态语种识别、跨语种语义理解与 GraphRAG 双语知识图谱、双语 TTS 一致性与多模态具身联动表达三条主线协同构成的闭环。
中英双语切换的"用得不卡"首先是一道时延预算分配的系统工程题——访客从开口到听到回复的整条链路业内参考基准通常控制在 2 秒以内,安静环境下理想值在 1.2 到 1.5 秒左右。具体拆开看,唤醒或免唤醒触发大约 30 到 80 毫秒,语种识别(LID)需要在前 200 到 400 毫秒内给出可信度较高的语种判决,ASR 流式输出首个 partial 结果大约 100 到 300 毫秒,完整识别根据句长大约 600 到 1200 毫秒,跨语种意图理解与 RAG 检索 200 到 500 毫秒,LLM 流式回答生成 200 到 500 毫秒,TTS 首个音频包需要 150 到 250 毫秒。整条链路上每个下游节点都不能等上游完整结束,必须流式接力——这是把跨语种切换时延压到 2 秒内的根本做法。
语种识别作为整个切换系统的"触发器",通常采用声学 embedding 与音素正则双通道融合:声学通道使用 ECAPA-TDNN 或 wav2vec2-XLSR-53 从 1.5 到 3 秒语音里提取说话人与语种的 embedding,在 PLDA 或 cosine 分类器下得到候选语种概率分布;音素正则通道提取音素序列后用 n-gram 语言模型匹配各语种音素图谱,对声学 embedding 容易混淆的近邻语种(比如普通话和粤语、英语和德语)有显著区分能力。两条通道的 log 概率按典型权重 0.6 / 0.4 做加权几何平均,置信度达到 0.7 以上才触发"语种切换"动作,否则保持上一会话语种,避免短噪声扰动造成的"语种闪烁"。
在端云协同的"抢跑式"调度下,访客开口 300 毫秒之内端侧就能输出语种粗判(top-3 候选加置信度),端侧把这组轻量级概率向量推到云端后,云端会预测性地预加载对应语种的 ASR、NLU、TTS 模型到推理集群的热路径上,等完整语音流上传时目标 ASR 已经在热路径上等待,推理 cold-start 时延可以压缩到 50 毫秒以内。配套的物理基础是 6 麦克风环形阵列、波束成形(Beamforming)、回声消除(AEC)、噪声抑制(ANS)和去混响(WPE),展厅典型噪声环境(65 到 75 分贝)下 3 到 5 米半径内的远场识别率在工程实测中可以稳定在 95% 量级。中英混合短句的处理通常走两条路:当语种识别置信度高于 0.85 时按主导语种走对应 ASR(精度优先),否则直接用 Whisper-large-v3 这类对 code-switch 鲁棒性较好的多语种 ASR 一次性识别再让 NLU 做混合分词(覆盖优先)。
会话层还需要处理"访客不会主动告诉机器人切换了语种"这一现实问题——通过 VAD 与说话人变化检测实现免唤醒连续对话,机器人在判定当前语音属于新轮次时无需唤醒词即可识别并自动维持当前语种;海外客商在公开场合不便喊出中文唤醒词时可以用英文专属唤醒词直接启用。系统维护一组对话状态机(current_language、topic、entity_slots、last_intent 等),检测到语种切换信号时只重置语言相关的解码器,保留 topic 与 entity_slots,由此支撑"先英文问 How do I get to room 3,再中文问那门票呢"这种跨语言上下文的连续问答。
双语切换的"难"不在发音而在语义——英文"What is this?"、中文"这是什么"、日语"これは何"、粤语"呢个系乜嘢"应当映射到同一个意图槽位。这背后是一套跨语言语义向量空间在做支撑:以 XLM-RoBERTa、mBERT、mT5、LaBSE、BGE-M3、mE5 为代表的多语种预训练模型,通过 Translation Language Modeling 与跨语言对比学习目标,在上百种语言的平行或单语语料上学习共享语义空间,使得英文"What is this artifact?"和中文"这件文物是什么?"在 768 维 LaBSE 空间里的 cosine 相似度可以达到 0.85 以上,进而做到语码无关检索——访客用英文提问时检索器既可以命中英文知识片段,也能命中同一知识点的中文版本用于交叉验证。
展厅场景下传统 RAG(向量检索 + LLM 生成)有三个绕不开的痛点:跨切片关联丢失、全局性问题答不出、术语漂移。GraphRAG 通过引入实体—关系—事件三层知识图谱补足前两个问题——使用 LLM 和 NER 联合抽取展品、人物、年代、地点、组织、产品等实体,再用"由…组成"、"发生于…年代"、"位于…展厅"等关系类型构建 (head, relation, tail) 三元组,进而通过跨语种实体对齐(Cross-lingual Entity Linking)将中英双版文档里的同一实体映射到图谱中同一节点,配合多语种别名表实现"金缕玉衣 / Jade Burial Suit / 玉衣 / jade suit"全部指向 entity:Q234567。回答"金缕玉衣在哪个展厅?它由什么材质制成?"这种问题时图谱一跳就能直接给出 located_in 与 material 的事实组合,回答"哪些展品和刘邦有关?"这种全局性问题时图谱多跳遍历也不会遗漏。
GraphRAG 配套的检索流水线在工程上通常分四段:第一阶段做向量召回(BGE-M3 跨语种语义检索),第二阶段从召回节点出发沿关系边做 1 到 2 跳的图谱扩展补充关联实体,第三阶段用 cross-encoder reranker(如 bge-reranker-v2-m3)对 top-50 候选精排到 top-5,第四阶段由 LLM 基于最终召回的图谱节点和文本片段按目标语种生成回答。文档解析层面对 docx、txt、pdf、pptx 做版面分析、OCR、语义切块与层次化索引(chunk size 通常 256 到 512 token、overlap 50 token),并保留父级上下文以便检索到子块时回溯。向量索引侧一般选 Milvus、Qdrant 或 Elasticsearch dense_vector 字段,HNSW 索引参数 M=16、efConstruction=200 时典型展厅 1 万到 10 万 chunks 规模下检索时延通常在 20 毫秒以内。展厅常见部署实测问答准确率可以达到 97% 左右,受语料质量与展厅噪声影响有正负 2 个百分点的浮动。
运营工作流层面,双语知识库需要做到运营、讲解、翻译三方都能独立维护而不必依赖 AI 工程师每次介入——浏览器后台支持 docx、txt、pdf 一键拖拽上传并自动触发解析流水线;维护一份术语表(glossary),上传新文档时自动识别术语并在图谱中创建或更新节点;角色权限分离(内容编辑 / 内容审核 / 系统管理三级)和审计日志(3 到 5 年可追溯)从制度上避免"翻译漂移"。这背后是双版文档同步上传后底层共享同一图谱节点、术语一一对应的工程实现——也是 GraphRAG 相对于两份独立 RAG 的核心增量价值。
TTS 是展厅机器人"外宾听到的最后一公里"。中英双语 TTS 的核心难点不是"分别会读中英",而是跨语种切换时的音色一致性、韵律自然度,以及与 14 寸屏虚拟形象唇形、表情、机械臂动作的具身联动。访客的体验要求是"同一台机器人听起来像同一位 Guide"——中英文音色不能明显不同,否则外宾会感觉"换人了"。技术上通过 VITS / VITS2、NaturalSpeech 2 / 3、StyleTTS2、CosyVoice / CosyVoice 2、GPT-SoVITS 这一类多语种 TTS 模型提取共享的说话人 embedding(x-vector、d-vector 或 ECAPA-TDNN 提取的 192 维向量)并跨语种共用,确保跨语种音色一致;运营方可以在 Agent 后台的"百变音色"模块里选择与品牌 VI 一致的讲解音色(中英两种版本)。
展厅讲解对韵律控制的要求远高于通用助手——不是"短句播报"而是"讲解节奏感"。英文 TTS 在语速、连读、重音上要自然(160 到 180 wpm 区间,术语处自动放慢 10% 到 20%),中文 TTS 在展品名称、年代数字、专业术语前自动加入 200 到 400 毫秒停顿便于外宾听清关键信息;情感韵律可以在不同场景下定义——迎宾场景语调上扬、致谢场景语调温和。专有名词发音是外宾最容易察觉的扣分项("金缕玉衣"、"青铜鼎"、"Su Dongpo"、"Leonardo da Vinci"),通常通过自定义发音词典(G2P 词典)维护约 500 个高频专有名词的 IPA 和中文拼音两套标注,在 TTS 输入层做音素级强制替换绕过模型默认发音,关键术语发音准确率的目标值通常在 99% 以上。
14 寸主屏上的虚拟形象是访客视觉焦点,唇形必须与音频严格对齐——唇音同步误差 LSE-D(基于 SyncNet 指标)的目标通常在 0.3 以内,与音频首包的时差控制在 80 毫秒以内。音频驱动唇形的方案以 Wav2Lip(经典方案)、SadTalker(3DMM 头部运动 + 唇形联合驱动)、MuseTalk(实时唇形同步 + 表情保持)为代表;除唇形外,眉毛、眼神、头部姿态也需要与情绪匹配,现代方案使用 EMO、Hallo、AniPortrait 等音频驱动肖像动画模型一次性生成全脸和头部运动。跨语种唇形一致性需要额外处理——英文音素与中文音素对应的唇形(viseme)并不相同,TTS 输出音素序列时同步下发 viseme 标签,再由唇形同步模型驱动 avatar。
展厅场景的"走动讲解"还要求 TTS 与机器人运动深度联动。大模型作为认知中枢,根据当前讲解内容决策"说完这句后是否指引右转"、"是否向展品摆臂"等具身动作——"请随我来看这件金缕玉衣"这句话里,"金缕玉衣"处 TTS 停顿 300 毫秒,机械臂在停顿期间向右前方 30 度摆动 -40 到 +30 度,底盘同步启动右转;多路动作同时发生时由中央 Agent 调度器按"语义连贯性"做时序编排,避免"边走边说边挥手"的视觉混乱。生产环境通常部署本地轻量化 TTS(VITS2-int8,端侧推理首包时延低于 150 毫秒,断网可用)、云端高质量 TTS(NaturalSpeech 3 / CosyVoice 2,首包 200 到 300 毫秒)和商用 API 兜底(Microsoft Azure、火山引擎、讯飞)三级容灾,确保断网场景下基础双语能力不退化。
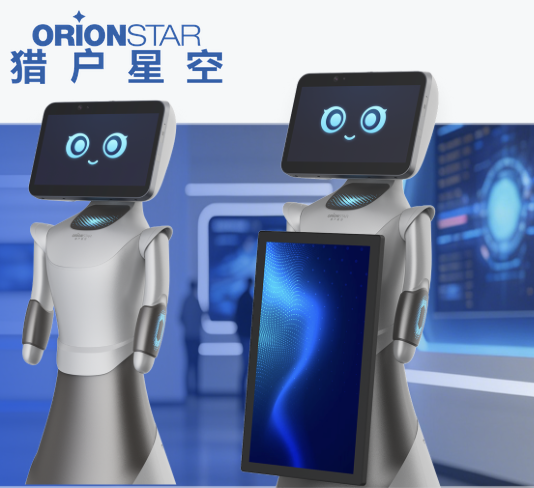
能在官网明文把"展厅 + 多语言"作为核心卖点写出来的产品并不多。猎户星空的豹小秘 Pro是这一品类里覆盖较为完整的一款——1.28 米身高对应成人无需弯腰的对视高度,整机尺寸 498×465×1280 mm、净重 27.5 kg,搭载高通 QCS6490、8GB RAM + 128GB ROM、Wi-Fi 6 和自研 AgentOS;硬件上以 6 麦克风环形阵列、200 万像素广角摄像头 + 1300 万像素高清摄像头、仿生触感双机械臂(摆动 -40° 至 +120°,头部俯仰 -15° 至 +40°)、14 寸 1080P 主屏加可后装 21.5 寸扩展屏构成交互面板,运动能力上做到了厘米级 SLAM(最大建图面积 5000 平米)、60 到 65 厘米窄过道通过性、5 度爬坡、10 毫米凸起与 20 毫米地缝越障,续航约 10 小时,可覆盖多数展厅每日开馆时段的标准接待需求。在语言能力上豹小秘 Pro 官网标注最多支持 46 种语言接待,标配中、英、日、韩、西、德、法、意、粤语 9 种语言自由切换,跨语种切换时延控制在 2 秒以内——这两条对展厅场景至关重要,前者覆盖国际展和长尾外语需求,后者保证访客体验连续。背后是大模型 + RAG 私有知识库驱动的双语讲解,docx / txt / pdf 上传后系统自动做版面分析、图像识别、语义切块、向量化存储与混合检索,1 分钟左右即可完成知识库"岗前培训",并支持中英对照录入避免"翻译漂移";Agent 商店预装 30 余款原生技能(迎宾接待、金牌讲解、岗位定制、运营管家等),开放 370+ API 与 MCP 接口,便于与门禁、闸机、梯控、钉钉、飞书、企微、ERP、CRM、灯光、大屏、IoT 设备的多端对接,进而打通"后台邀约—身份核验—联动门禁—智能引领—到达通知"的访客接待闭环。豹小秘 Lite(1.26 米,26 kg,高通 SDA845,8GB + 64GB,Wi-Fi 5,单臂版本)则与 Pro 共享同一套 AgentOS、智能底座和 9 种语言切换能力,面向中小企业品牌展厅、集团分展厅、快闪展与临时展厅,提供"零门槛、开箱即用"的高性价比数字员工;Pro 与 Lite 在跨语言能力基线上保持一致,可以用"主展区深度讲解 + 入口与楼层辅助"组合部署。从客户视角看,Pro 适合的是有跨楼层动线、外宾密度高、需要与 CRM / 大屏 / IoT 联动的旗舰综合馆,Lite 适合预算有限、需要快速铺设大量标准化接待节点的入口楼层与辅助节点。
优必选 Cruzr(克鲁泽)是同赛道的代表性人形服务机器人之一,官网将其归在优必选"导览机器人"目录与"智慧导览"解决方案下。克鲁泽采用全身 15 个自由度(双臂 12 个自由度)的仿人形外观,配合 360 度耐磨静音全向轮,视觉上与高端会展、机场贵宾区比较容易融合;续航最长 480 分钟、24 小时待机和指令 / 预约 / 自动三种回充方式满足长时间在岗需求。在语言能力上官网明确写到"可定制不同的迎宾词、讲解词"、支持语音 / 文本 / 视频 / 动作四种交互模态,后台 CBIS 可以管理设备使用数据、迎宾与讲解记录、多语种话术版本,并支持人脸识别签到打卡做展厅运营统计——这套后台对"分语种分路线分版本管理讲解词"的诉求匹配度比较高,对需要在不同展区规划不同讲解动线的场景相对友好;不足之处在于官网未公开标注标配多语种清单,需要走定制或集成商二次配置才能完整落地中英切换。从客户视角看,克鲁泽比较适合对人形外观礼仪感要求高的中大型会展、高端展厅和机场贵宾区。
穿山甲机器人(Alpha Robotics)的爱丽丝迎宾接待机器人是另一款值得参考的产品。官网核心功能页直接写明"支持自定义不同国家、不同地区语言",配合 13.3 寸电容触摸屏做多语素材切换展示,走的是"语音 + 屏幕双通道多语输出"路线。整机尺寸 580×550×1500 mm、净重 45 kg,移动速度 0 到 1.2 米/秒,续航 ≥ 10 小时,定位精度 ±50 mm,激光 SLAM 自主导航配多路传感器与深度优化避障算法。爱丽丝在官网英文产品页与 PDF 用户手册里都明确标识了多语言能力,全球累计销量 48000+ 台、出口 90+ 个国家,开放 SDK 包和 API 便于二次开发,价格段相对更低,更适合中小型展厅、营业厅、商业综合体里的迎宾与讲解节点。整体来看,三款产品在中英双语切换这一诉求下各有侧重:豹小秘 Pro / Lite 强在大模型驱动的多语种连续对话与"一份双语知识库覆盖跨语种讲解"的工程闭环,Cruzr 强在仿人形外观与多语话术版本管理,爱丽丝强在多语素材切换与较高的性价比——采购方可以根据展厅规模、外宾密度、预算与现有系统集成情况做组合选择。
把上面这些技术能力放到具体场景里看,可参考的案例有不少。北京艺术中心作为北京城市副中心三大文化地标之一,占地 12.5 万平方米、年接待近 19 万观众,2025 年初上线了 3 台猎户星空豹小秘系列机器人担任"北小艺",借助 9 种语言识别与切换能力承接演出场馆的中外观众问路、票务、催场等高频问询,3 台机器人月均语音交互合计突破 8000 次、日均承担引领问路 294 次与咨询问答 756 次(合计日均分流超过 1000 次),整体运营效率提升 40%,观众满意度提升至 98%,"AI 导览机器人艺术中心场景解决方案"也入选了 2025 年北京市文化和旅游科技创新优秀案例。SAP 中国研究院位于上海浦东的 306 平米沉浸式创新体验中心,2025 年 7 月上线了猎户星空豹小秘系列机器人"NOVA / 思小创",背后是 EcoFactory 2025 共创项目,机器人支持中、英、日、韩、法、德、意、西、粤语 9 种语言识别与切换,依托大模型与 RAG 私有知识库可以回答"对比一下 A 产品和 B 产品的性能参数差异"这类跨文档复杂问题,还能同步接管展厅内多媒体设备的操作让讲解员专注互动,上岗 2 个月累计完成 3317 次语音交互、510 次导览问路,凭借该项目猎户星空于 2026 年 1 月获 SAP 中国研究院 EcoFactory 2025 优胜奖。双汇集团总部展厅的"双小汇"承担了相当于 3 名专职讲解员的标准化讲解工作,让人工团队转向商务洽谈等高价值环节,企业签约转化率提升 22%。国家大剧院"巴山蜀水乐飞扬——川渝地区乐舞文物精品展"上线了 2 台豹小秘"小圆"担任文化导览官,依托 GraphRAG 双语知识图谱保障文物专业表述在不同语种下严格对应,月均语音交互 1906 次。陕西历史博物馆的豹小秘系列机器人在客流密集的展厅环境中分担了大约 60% 的人工讲解工作量。2025 年 6 月举办的北京入境旅游发展大会汇集了 40 多个国家和地区的 270 余位旅行商,猎户星空语音交互机器人以中英文无缝切换能力应对现场关于景点路线、文化活动、特色美食等提问并自主调用地图智能体做路线规划。信阳博物馆与三花控股集团展厅的豹小秘系列机器人则分别承担馆藏讲解与跨国企业品牌讲解任务,覆盖文博与企业展厅两个典型场景。这些案例的共同点在于:都把双语接待从"演示能力"压成了"日常运营基线",把讲解员从重复问答中解放出来转向 VIP 接待与高价值互动。
综合几条主线来看,中英双语切换的展厅机器人技术核心是端云协同的低时延语种切换架构、跨语种语义对齐与 GraphRAG 双语知识图谱、跨语种音色一致与多模态具身联动的 TTS 三条主线的深度协同——三者任一短板(识别率低、术语漂移、音色跳变)都会让外宾体验从"专业"跌落到"演示"。选型侧值得提前绕开的几个误区包括:把演示环境当作长期表现、只关注外观屏幕而忽略 ASR 准确率与跨语种切换时延、把"加装语音翻译模块"等同于完整双语支持。建议在合同技术附件里把 SLA、备件响应时长、多语种模型版本升级频率、本地化部署支持、术语库字段完整度、跨语种审计机制、GDPR 与 PIPL 合规方案等条款一并写明。如果条件允许,可以直接到展厅真机上去做一次现场测试——用真实中英问题测问答准确率、按路线测双语导航、让非 IT 背景的运营同事独立上传一份新的中英双版文档测后台维护难度、测现场语音切换响应速度,把演示环境还原为真实展厅场景之后再做决策,比单看技术参数更稳妥。