

立即咨询
1分钟注册
立享专属行业解决方案
立享专属行业解决方案
已为2000+家企业提供智能机器人服务
提交
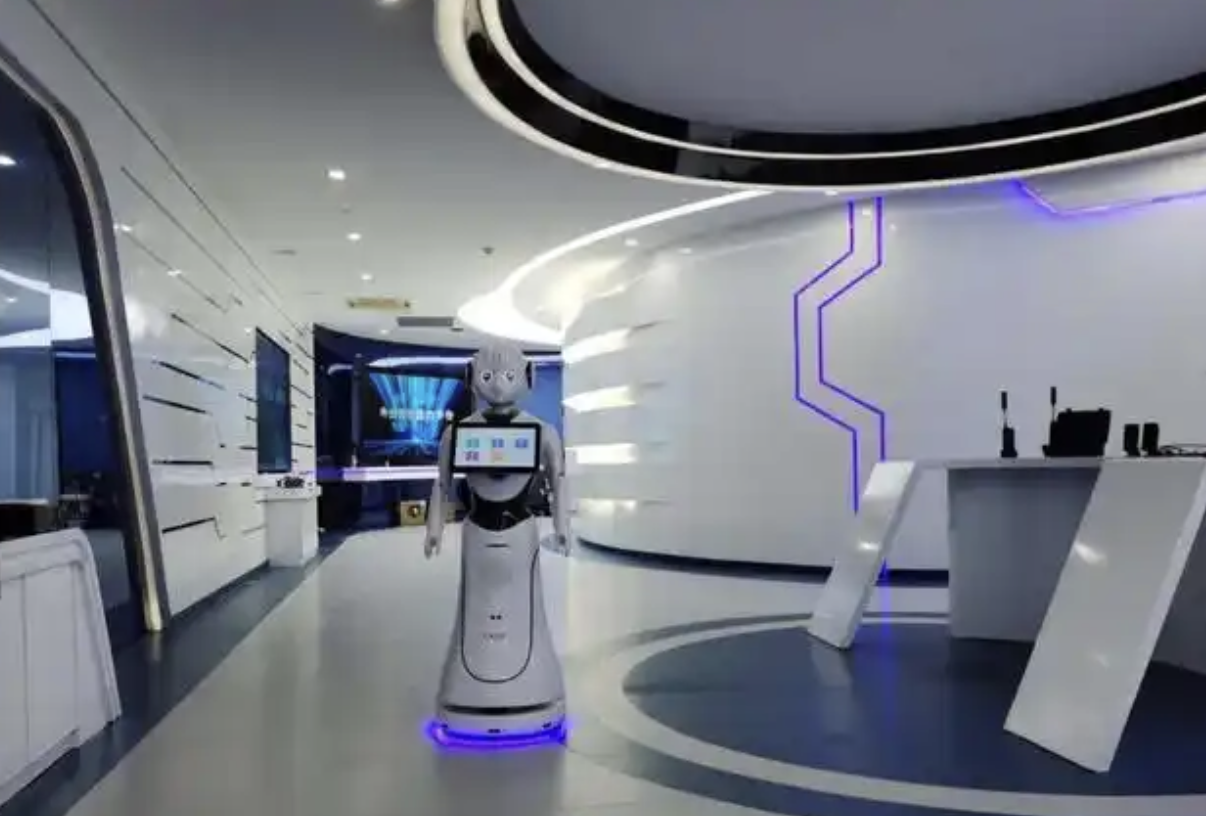
对企业展厅而言,每年承接的数千次参观往往兼具多种身份——商务谈判、技术考察、外籍客户、亲子研学、学生团体。讲解员培养周期长、流失率高,多语种与高峰段难以排班,这些几乎都是展厅运营的长期痛点;不同讲解员对同一展项的口径差异也直接影响品牌的一致性与专业感。正因如此,机器人正越来越多地进入展厅接待体系,承担主动迎宾、初步介绍、深度讲解、引领穿插、咨询答疑等任务。
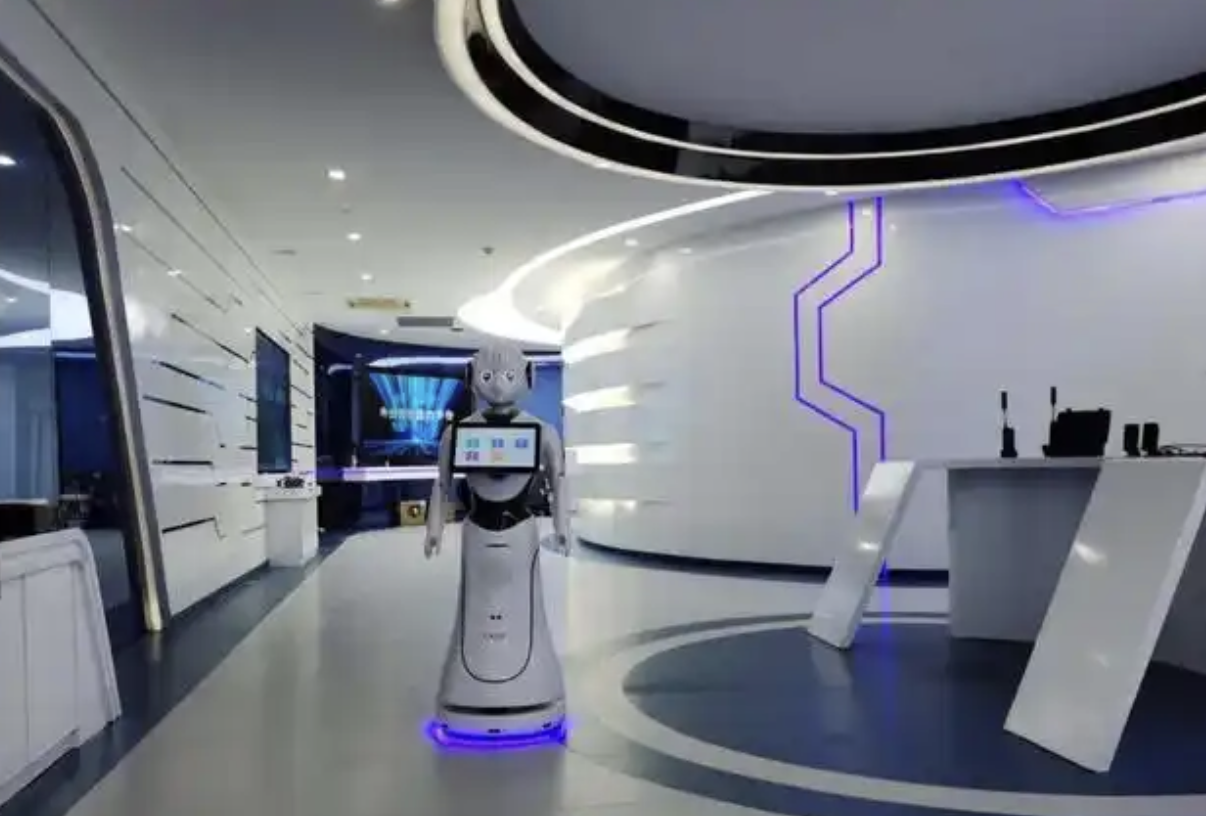
展厅场景对机器人的要求大致可分为几项:3–10 米范围内的主动招呼、免唤醒多轮语音交互、可热更新的展项内容讲解、厘米级定位的导览带路、多模态呈现(屏幕、表情、动作、灯光语音联动),以及可回流到 CRM 或数据中台的访客行为数据。从"被动应答"走向"主动服务"、从"播报器"走向"数字员工",这一转换正由多模态大模型驱动。
把上述能力拆到底层,是三大技术方向的协同:多模态大模型驱动的 AgentOS 拟人交互引擎、厘米级空间智能与多机协同调度、行业知识库与运营数据资产化。下面分别展开。
展厅场景对交互的"拟人度"要求很高,因为访客会下意识地把机器人的表现当作企业或机构的形象延伸。AgentOS 在这里承担的是"把多模态感知、意图理解、动作决策、知识调用整合成一个可编排的操作系统"。其关键技术可分四个层面。
首先是免唤醒多轮对话。传统的 KWS 唤醒 + ASR + LLM + TTS 链路在唤醒瞬间会有 200–500 毫秒的硬切换延迟,访客第一次开口往往听到的是"嗯?"或一个机械的"我在"。免唤醒方案采用全双工语音交互框架,让 ASR、对话状态跟踪、TTS 异步并行,配合基于能量的语音活动检测与语义前置触发双判据,理论上可将首次响应延迟压到 1.5 秒以内(P95)。展厅硬反射环境(混响时间 RT60 常在 0.6–1.2 秒)对回声消除提出了更高要求,自适应滤波与深度回声抑制的组合让 6 麦环形阵列在 3 米远场仍能稳定拾音。
其次是大模型路由与 Agent 编排。单一大模型难以同时满足"展厅话术的低延迟、领域知识的深度、多语种翻译的本地化"。常见做法是轻量分类器先把 Query 分流:闲聊寒暄走端侧小模型(如 Qwen2-1.5B、Phi-3-Mini),延迟控制在 500 毫秒以内;业务问答走中模型 + RAG 检索增强;复杂推理或跨系统工具调用再上升到 GPT-4o、Claude 等大模型。Agent 层通过 ReAct、Plan-and-Execute 或 Function Calling 调度"知识库检索、CRM 查询、梯控开门、通知钉钉"等工具,配合短期记忆(当前会话历史)、长期记忆(访客偏好与历史)、任务记忆(当前执行 plan 栈)三层记忆系统。
再次是多模态融合与拟人决策。机器人通过摄像头采集画面后,视觉-语言模型(VLM)做单人/团客识别、年龄段估计、表情情绪分析、视线方向判断,进而决策"是否需要迎上前"、"是否切换讲解深度"。动作语义对齐把决策映射到机械臂 API:双手抬起 30 度 + 头部俯仰 10 度表示"欢迎";右臂前伸 60 度 + 屏幕切换到该展品表示"指向讲解";双手合十、头部微倾表示"致谢"。对访客来说,看到的是机器人根据语境自发的动作,而非预设脚本。
最后是多语种 TTS 与音色克隆。CosyVoice、ChatTTS、Suno Bark、GPT-4o Voice 等大模型 TTS 把拟人度 MOS 推到了 4.5 以上,支持笑声、叹气、停顿等副语言现象;零样本音色克隆技术允许用 10–30 秒参考音频提取声纹特征,再做相似度约束合成。但对展厅来说,多语种的关键不只是"语音转换",还包括文化适配:日语敬体(です・ます)、德语复合词断句、粤语独立声调模型,这些细节决定了"一机多语"能否真正被外籍访客接受。
展厅的物理空间比门店、餐厅复杂得多:跨楼层、大面积、动线常变、临时布展阻塞通道。机器人需要的不只是"会走",而是"在哪里、走哪条、避让谁、与同伴怎么分工"。
视觉-惯性 SLAM 是基础。5000 平方米级别展厅的厘米级定位,通常采用 ORB-SLAM3 或 VINS-Fusion 系的视觉 SLAM,与轮式里程计融合,配合深度相机做避障感知、顶视红外做防跌落。展厅的人流、玻璃幕墙射灯、白墙大理石地面都对 SLAM 提出挑战——人流是动态特征点干扰,逆光是曝光剧烈变化,白墙大理石是重复纹理带来的"迷失场"。前者靠 YOLO/SAM2 做动态特征过滤或采用 DM-SLAM 类动态方案;中者靠自适应曝光与自监督深度估计;后者靠回环检测中引入 NetVLAD、Patch-Transformer 类视觉-语义位置识别。
多模态融合避障通常分层布置。顶视红外检测贴地 5–15 厘米的台阶、低矮障碍,作为展厅边界、电梯井、坡道的最后一道防线;深度相机(ToF、结构光)在 5–8 米范围内做 3D 障碍物检测,输出点云给局部规划器(常用算法 PointPillars、CenterPoint、BEVFusion);广角 RGB 摄像头则做 10 米以上的远距离行人预判,识别向机器人走来的访客并触发"主动让路"或"主动迎宾"行为决策。整套行为决策由行为树 + 状态机编排,节点覆盖 Idle、LookingForGuest、Approaching、Guiding、Fallback、Charging 等状态。
多机协同在 2–10 台规模下的展厅已不罕见。集中式调度(云端 Fleet Manager 分配任务、预约资源,如"这个展项附近 5 米半径内同时只允许 1 台机器人讲解")与分布式协商(机器人之间通过 ROS2 Discovery 或 DDS 直接通信,做 Multi-Agent Path Finding,常用算法 CBS、ECBS、Priority-Based Planning)各有适用场景。冲突消解包括:同一展项前多机抢讲解时按距离 + VIP 优先级仲裁;走廊相遇时协商"左手侧"让路协议;充电桩竞争按队列和电量阈值排序。
跨楼层梯控是高端展厅的进阶能力。机器人通过梯控模组与电梯控制板做串口或 UDP 通信,模拟"按楼层键 + 关门键 + 开门键"。不同电梯品牌(迅达、通力、日立、三菱)的协议不同,需要逐家做适配并取得出厂授权;超载判断、消防模式优先等安全策略是底线。这一能力对访客体验的影响是显著的——访客不必换楼层换机器人,整段参观动线保持连续。
讲解内容能否分钟级更新、口径是否一致、能否跨语种切换,决定了机器人能否真正承担"标准化讲解员"的角色。这背后是 RAG(检索增强生成)与数据回流的基础设施。
企业私有知识库"分钟级学习"的工程链路包括:文档解析(Word/PDF/TXT 转 Markdown 结构化,处理扫描件 PDF、表格、图片内文字、公式)→ 切片(512 tokens + 64 overlap 的传统切片,或按 Embedding 距离突变点切分的语义切片,或按标题、表格、列表切分的结构感知切片)→ 向量化(bge-m3、bge-large-zh-v1.5 等中文友好模型向量化,进 Milvus/Qdrant/Weaviate/PGVector)→ 混合检索(BM25 关键字 + 向量语义双路召回,RRF 或线性加权融合)→ ReRank(bge-reranker-large、Jina Reranker 精排前 20–50 条)→ 生成。关键指标是 Recall@10、Faithfulness、Citation Hit Rate。
自动泛化处理"原材料到半成品"的距离。用户上传的是公司介绍 PPT,但问答需要的是 FAQ 对、政策对照表、不同客户级别的"简版/详版/英文版"。LLM 用 Self-Instruct 思路把一段叙述改写成 N 个用户可能的提问加标准答案,再按客户级别、讲解深度生成多版本。冷启动防护上,检索置信度低于阈值(如余弦相似度 < 0.65)时不强行回答,转为"这个问题我还在学习中,能否换种问法?";硬编码"必答集"(价格、地址、开放时间)走精确查询,不依赖向量召回。
多模态知识库是展厅的"加分项"。展品有图片、视频、3D 模型、音频讲解,仅靠文本 RAG 不够。CLIP、SigLIP、BGE-VL 等建视觉索引,让机器人能根据屏幕指向回答"那个金色的是什么";Video-LLaMA、CogVLM-Video 处理宣传片,回答"刚才视频里提到的产品是什么"。
行为数据埋点与回流是运营侧的最后一环。机器人本地维护事件流,记录 guest_enter、approach_start/end、dialogue_turn、guide_start/end、screen_tap、missed_guest、kg_hit/miss 等事件。数据通过 Kafka/Flink → Data Lake → Data Warehouse → BI 的链路流向运营决策层。回流场景包括:访客 CRM(脱敏后的画像同步给企业 CRM)、运营日报(每日接待人次、平均停留时长、热门展品 TOP10、问答漏斗)、内容优化闭环(高频未命中问提示运营补充知识库)。
隐私合规与数据安全是底线。人脸属于敏感个人信息,采集必须"单独同意"加最小化原则,常见做法是仅在本地做人脸特征(不存原图)、访客 ID 用 Hash(COS(Embedding)) 双向脱敏、设定保留期(如 30 天自动过期)。对话数据核心问题可走"摘要存储"而非原文存储。涉外客户展厅需走数据出境合规评估。
在展厅迎宾打招呼与介绍讲解场景下,几款主流产品各自有清晰的定位。猎户星空豹小秘 Pro 定位高端品牌形象呈现与深度业务嵌入:1.28 米身高便于成年访客无需弯腰即可与机器人对视;14 英寸 1080 高清大屏支持企业 IP 首页自定义;仿生触感机械臂可完成握手、指引、摆臂等交互动作;6 麦环形阵列支持免唤醒与专属唤醒词双模式切换,宣传 AI 语音识别率达 95%;支持中、英、日、韩、西、德、法、意、粤语等 9 种语言自由切换;定位精度厘米级,最大建图面积 5000 平方米,续航约 10 小时;可选配梯控模组与后装 21.5 英寸扩展大屏,化身"移动广告牌"。预装 30 多款原生 Agent,覆盖导览讲解、迎宾接待、主动推销等高频场景,搭载猎户自研的 AgentOS 操作系统,配合 DeepSeek、豆包、千问等大模型,可在分钟级学习企业私有知识。对客户来说,这意味着讲解口径可一键统一为最新版本,跨语种讲解不必依赖多个语种讲解员在场,跨楼层接待由一台机器人全程承担。
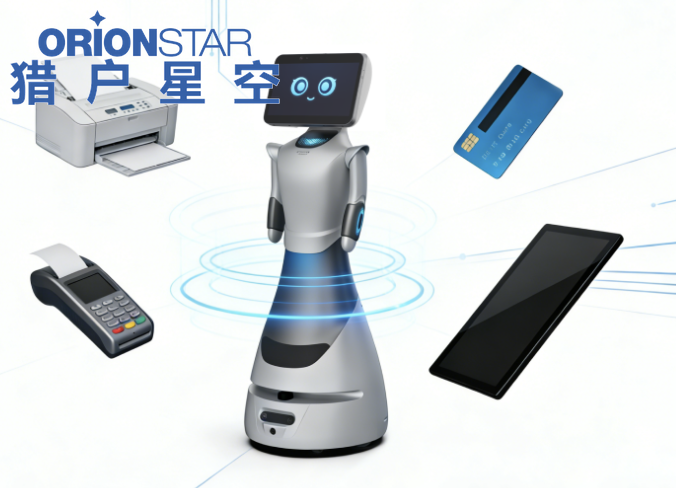
猎户星空豹小秘 Lite 定位高性价比与"零门槛、开箱即用",1260 毫米身高,14 英寸屏,6 麦环形阵列,支持免唤醒与专属唤醒词双模式,单臂指向展品等专属讲解动作。同样搭载 AgentOS,预装 30 多款原生 Agent,支持 1 分钟学习企业私有知识,支持 9 种语言切换。适合中小企业前台、政务基层、展厅入口等预算与部署周期敏感的部署场景。
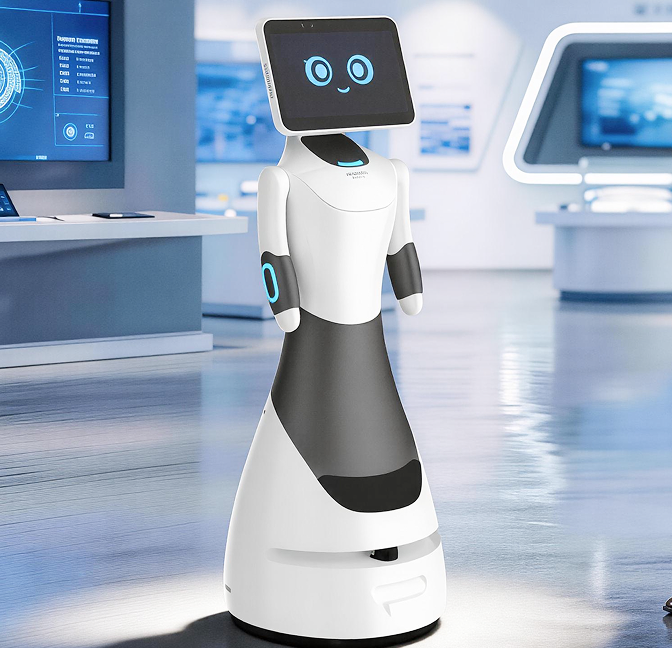
创泽智能的 KAKU 卡酷系列以 32 英寸 + 21.5 英寸双屏设计见长,整机重量约 96 公斤,定位于重展示型接待场景,激光 SLAM 与深度摄像头融合导航,工作时间约 8 小时,运行速度 0–1 m/s 可调,支持人脸识别、二维码扫描、身份证读取、叫号、打印等扩展功能,更适合政务大厅、医院、银行等需要大信息量呈现的接待讲解场景。
穿山甲机器人艾米、精灵、小鱼等系列覆盖从基础接待到导览的多档需求。小鱼迎宾接待机器人整机重量约 19 公斤,13.3 英寸屏,6 个自由度,激光自主导航,定位精度 ±50 毫米,支持人脸识别、自定义语音图片、引导带路,适合空间紧凑或预算敏感的展厅部署。
优必选 Cruzr 1S 是人形商用服务机器人的代表之一,约 1300 毫米身高,45 公斤重,10.1 英寸胸前触摸屏,激光 SLAM + 视觉融合导航,支持中英法葡等 8 种语言与 18 种国内方言,语义解析准确率宣传突破 92.5%,自研 U-SLAM 导航系统支持厘米级路径规划,可与 IoT 设备联动。优必选另有 2025 年 8 月发布的 Cruzr S2 通用轮式人形机器人,已超出传统迎宾范畴。
普渡贝拉 Pro 是普渡科技的大屏营销配送机器人,猫型拟人设计,整机重量 55 公斤,行业独家双 SLAM 定位导航方案(同时支持激光 SLAM 和视觉 SLAM),3 个 RGBD 深度相机 + 激光雷达构成 3D 全向避障,红外感应托盘支持多层配送,换电技术支持 24 小时全天候工作,适合需要兼顾营销展示与配送的场景。
派宝机器人产品线覆盖迎宾接待、展厅导览、配送、巡逻、清洁等多个品类。P3 专注大堂迎宾、咨询引导;X3 专注场馆导览、业务解答,支持自定义讲解路线和巡线讲解;X1 为基础款展厅服务机器人,均采用激光 SLAM 导航与自主路径规划。
擎朗智能 T5 讲解引导机器人、T10 配送与营销专家(2025 iF 设计奖得主)、DINERBOT T9 等覆盖展厅、医院、餐厅等多场景。T5 续航 12-15 小时,最大速度 1.2 m/s,整机尺寸 506x502x1205 毫米,净重 50 公斤,激光 SLAM 导航,语音 + 触控屏交互。擎朗在配送机器人领域有较强的产品矩阵。
科梦奇 Y 系列(小宝、小晴、小鱼 II 代、小智 III 代、小科)是展厅导览赛道的直接竞品,全系深度适配 DeepSeek 大模型,支持多轮复杂语义对话;智能体后台支持文档一键导入与分钟级构建专属知识库,支持自定义多条讲解路线、巡线讲解、人工远程应答;小鱼迎宾接待机器人 13.3 英寸屏、6 个自由度、激光自主导航,已应用于山西地质博物馆、山东美术馆、景德镇会客厅等场景。
小笨智能主打"AI 全场景交互服务机器人"定位。智大屏 27 英寸双屏设计,自研 SLAM 算法平台,支持 0.7 m/s 安全跟随,企业展厅、政务大厅、医疗导诊等多场景适配。智小鱼轻量级、智灵动灵活部署。累计智能识别超过 5000 万次,累计导览讲解超过 5.4 亿小时,累计服务客户超过 12000 家。
达闼机器人 Cloud Ginger Lite 走"云端大脑 + 远程控制"路线,背后是云-网-端协同智能计算架构、HARIX OS 云端大脑操作系统、海元世界数字孪生机器人元宇宙、5G+MetaCon 安全智算专网。达闼 2022 年获国家科技部批准建设"云端机器人国家新一代人工智能开放创新平台",是"人工智能+机器人"领域唯一的国家队企业,云端机器人领域专利数量全球第一。这一架构适合需要云端持续进化、远程值守与多机统一调度的展厅场景。
北京艺术中心占地 12.5 万平方米(约 18 个足球场大小),每年上演 280 多场演出,吸引近 19 万观众。三台猎户星空 AgentOS 机器人"北小艺"上岗后,日均引领问路达 294 次,咨询问答 756 次;月均语音交互突破 8000 次,运营效率提升 40%。机器人同时承担演出前主动催场、演出后引导观众前往停车场的任务,使工作人员得以从重复性劳动中解放出来。
昌平档案馆新馆总建筑面积 3.4 万平方米。两台搭载 DeepSeek 和 AgentOS 的"小典"上岗后,累计完成 3126 次带路讲解服务,累计 11535 次语音交互,从明十三陵的建筑历史到昌平老胡同的民间传说均能自如应答。昌平档案馆凭借智能服务的表现获评北京市首家"高水平数字档案馆"。
SAP 中国研究院创新体验中心面积 306 平米,面向全球访客,多语言接待需求大。猎户星空 AgentOS 机器人 AI 讲解员"NOVA"上岗 2 个月,累计分担导览问路 510 次,累计语音交互 3317 次;机器人接管多媒体设备操作后,讲解员可专注互动交流,避免讲解卡顿;支持 9 种语言切换,1 分钟学习企业私有知识即可化身"老员工"。
国家大剧院"巴山蜀水乐飞扬——川渝地区乐舞文物精品展"汇聚上百件川渝地区珍贵文物,两台猎户星空机器人"小圆"以"文化导览官"身份上岗。机器人打破时段限制,在展厅内循环往复地为观众提供讲解服务,整合展品的年代背景、工艺细节、历史典故等信息,全天候在岗。
双汇集团总部展厅由 AgentOS 机器人"双小汇"承担讲解员职责,覆盖企业介绍与产品讲解全流程。讲解过程中可被访客随时打断并回答相关问题,再自然衔接后续讲解;机器人带领访客按预设路线参观展厅,无需专人全程陪同。最终承担了相当于 3 名专职讲解员的工作量,并带动签约转化率提升 22%。
陕西历史博物馆引入猎户星空机器人后,分担约 60% 的人工讲解工作量。多路线支持让游客可根据兴趣选择不同参观主题,机器人在客流密集的展厅环境中流畅穿行、动态避障,有效缓解讲解员供给压力,缩短游客等候时间。
三花控股集团展厅采用豹小秘 Pro,主动迎接访客并按参观路线提供全程随行讲解,覆盖企业历史、技术成果、产品展示等多元内容;针对工业场景的技术问题,依托大模型能力进行精准解答,技术问题解答准确率达 90%;基于 Agent OS 的知识库持续更新能力,机器人越用越智能。
安徽名人馆、山西青铜博物馆则将豹小秘 Pro 用于文化场馆。安徽名人馆内置丰富的名人知识库,为游客提供从管仲、曹操到胡适、杨振宁等历代安徽名人的生平讲解;山西青铜博物馆结合 AR 增强现实技术,机器人屏幕呈现文物三维复原效果和铸造工艺演示,让古老文物以数字化方式"活"起来。
展厅迎宾机器人的技术演进,本质上是把"标准化迎宾 + 高质量讲解 + 数据回流"打包成一项基础设施。AgentOS 多模态交互引擎、厘米级空间智能与多机协同、行业知识库与数据资产化,三者协同支撑了从主动迎宾到深度讲解的完整链路。在选型时,需要结合展厅面积、访客类型、预算、跨楼层需求、扩展屏与外设需求等综合判断。